

‘예측’의 사전적 의미는 “미리 헤아려 짐작함”이다. 여기서 ‘헤아림’은 과거의 사건을 기반으로 현재 상황을 고려한 정량적 혹은 정성적 살핌이고, ‘짐작’은 이러한 헤아림에 근거하여 미래의 상황을 미리 판단하는 행위이다. 바로 이 헤아림과 판단에 과학적 혹은 비과학적 접근이 있을 수 있다.
과거에는 개인의 경험이나 직감이 헤아림과 판단을 위한 수단이었다면, 지금 인공지능 시대에는 데이터에 기반한 과학적이고 객관적인 헤아림과 판단을 해야 한다.
개인의 일상에서의 예측은 유익하고 재미있는 이벤트일 수 있지만, 기업에서의 예측은 생존과 직결될 수 있어 더욱 신중하고 과학적으로 접근해야 한다. 그러나 지금도 많은 기업들은 과거의 성과와 경험에 기반한 수요 예측, 유지보수, 마케팅 성과 예측, 인사 평가, 품질 예측, 재고 최적화 등 여러 도메인에서 비과학적인 예측과 실행을 하고 있다.
데이터에 기반한 과학적 의사결정은 교과서에서나 나오는 이론이거나, 따라 하기 어려운 특별한 타사 사례로 인식하고 있는 것도 사실이다.
기업 경영에서 예측은 결코 쉽거나, 데이터만 쌓이면 자동으로 될 수 있다는 것은 아니다. 데이터의 가치 인식에 공감하고, 데이터 거버넌스에 따라 고품질의 데이터를 축적하여 활용하고, 데이터에 기반한 의사결정이 당연하게 받아들여지는 기업문화가 만들어졌다면, 예측을 위한 가장 적정한 도구인 ‘기계학습(Machine Learning)’과 데이터분석 전문가에 의하여 과학적으로 예측 모형(Model)을 만들어 의미 있는 성과를 낼 수 있다.
1959년 Arthur Samuel이 “명시적인 프로그래밍이 아닌, 컴퓨터가 학습할 수 있는 능력을 갖추게 하는 연구 분야”라고 정의한 기계학습은, 지금의 인공지능 구현에 중요한 한 축을 형성하고 있다. Samuel의 정의를 조금 더 풀어보면, 데이터와 알고리즘을 이용한 학습을 통해 패턴과 파라미터를 찾아, 작동할 수 있는 모형을 만들어, 새로운 데이터나 상황에 대하여 예측하고 결정을 내릴 수 있는 일련의 과정과 결과물, 즉 모형을 기계학습이라고 할 수 있다.
기계학습 과정은 기계학습용 데이터를 준비하고, 알고리즘으로 데이터를 학습하여 모형을 만들고, 모형의 업무 적용성을 평가하는 프로세스라고 할 수 있다.
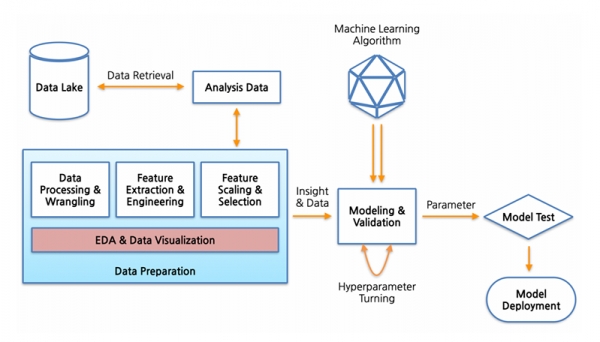
기계학습은 학습의 형태에 따라, 지도학습(Supervised Learning), 비지도학습(Unsupervised Learning) 그리고 강화학습(Reinforcement Learning)으로 나뉘고 필요에 따라 반지도학습, 연합학습 등으로 세분되기도 한다. 여기서 학습의 형태는 학습에 참여하는 데이터의 구조와 알고리즘에 따라 나누어지고, 학습의 결과물인 모형이 어떠한 용도로 사용되느냐에 따라 학습 방법을 판단해야 한다.
기계학습은 학습을 위한 데이터 세트의 준비, 기계학습을 위한 알고리즘 선택, 기계학습 결과물인 모형의 평가가 중요한 요소로써, 데이터분석 전문가나 데이터 과학자의 역량을 충분히 발휘할 수 있는 단계 중의 하나이다.
먼저 데이터 세트 준비에서는 기계학습만을 위한 데이터프레임(Data Frame)과 데이터 파티션(Data Partition) 그리고 데이터 불균형(Data Imbalance) 해소 등의 이해가 필요하다. 그리고 학습에 필요한 알고리즘, 즉 Regression, k-NN, Ensemble, SVM, Neural Network, k-Means, DBSCAN, t-SNE, Q-Learning, Apriori, GAN, SOM, HMM 등 수백 가지가 넘는 알고리즘에 대한 작동 원리와 이를 바탕으로 적정한 알고리즘의 선택과 효율적 학습을 위한 하이퍼 파라미터의 설정 방법 등을 알고 있어야 한다. 끝으로 기계학습 모형의 평가 기준, 즉 메트릭스(Metrics)의 적정한 설정과 평가, 그리고 데이터 변화(Data Drift)에 따른 재학습 기준 설정 등의 방안을 마련할 수 있어야 한다.
기계학습을 통하여 모형을 만들어가는 것은 분명 전문가의 영역임은 분명하다. 비전문가들의 어설픈 기계학습의 결과물은 데이터과학을 실험실 수준의 결과물에 머물게 할 수도 있다. 따라서 기업은 사내 데이터분석 전문가를 양성하고 CoE(Center of Excellence)와 같은 전문 조직을 만들어 체계적이고 전문적으로 기계학습을 적극 활용할 필요가 있다.
